Kann KI (inzwischen) Noten lesen und schreiben?
Vor einem halben Jahr sind allgemeine Sprachmodelle noch daran gescheitert, eine Chorpartitur zu lesen: Den Text rund um die Musik haben sie verstanden, die Noten aber erfunden. Dieser Artikel vergleicht den damaligen Versuch mit einem neuen aus dem September, zeigt, wie heutige Modelle einen schlechten Scan mit selbst geschriebenen Werkzeugen in den Griff bekommen, und was das für Aufgaben bedeutet, die wir unter „noch nicht“ abgelegt hatten.
Neben meiner Arbeit in der IT singe ich schon seit ein paar Jahren in Dresdner Chören. Eine viel genutzte Chorpartitur kann nach ein paar Monaten Proben sehr unübersichtlich werden: Bleistiftnotizen aus etlichen Proben und womöglich von mehreren Sängerinnen und Sängern, Atemzeichen, Dynamik, eine durchgestrichene Note, ein Pfeil, der eine Silbe auf eine andere Note verschiebt. Kommt dann noch eine schlechte Druckqualität dazu, ist irgendwann wirklich schwer zu erkennen, worauf es eigentlich ankommt.
Wie weit KI inzwischen ist, darüber gehen die Meinungen weit auseinander, und es hängt stark davon ab, wer gerade spricht: Wir Entwicklerinnen und Entwickler reden vor allem übers Programmieren, in den Medien geht es eher darum, wo wir auf dem Weg zu AGI stehen. Beide Diskussionen bleiben oft ziemlich abstrakt. Deshalb prüfe ich den Fortschritt gern an etwas Kleinem, Konkretem, das mir wirklich am Herzen liegt. In meinem Fall wollte ich eine eingescannte Chorpartitur an ein Modell geben und daraus eine saubere, bearbeitbare Partitur in MuseScore machen lassen.
Damit klar ist, welche KI ich meine: Spezialisierte Software dafür gibt es schon länger. Sogenannte OMR-Tools (Optical Music Recognition) wurden genau dafür entwickelt, gedruckte Noten in Notensatz zu verwandeln, und bei einem sauberen Druck sind sie vermutlich immer noch die bessere Wahl (sie kosten allerdings meist eine ordentliche Lizenzgebühr extra). Meine Frage war eine andere: Schaffen das auch die allgemeinen Sprachmodelle, auf die heute praktisch jede Person Zugriff hat (dieselben, mit denen wir auch Code schreiben), inklusive der handschriftlichen Änderungen und der Ermessensentscheidungen, die dazugehören?
Vor etwa einem halben Jahr habe ich genau das ausprobiert, und es hat schlicht nicht funktioniert. Im September habe ich es noch einmal versucht, und siehe da: Es hat geklappt.
In diesem Artikel möchte ich eine Momentaufnahme dieses Unterschieds teilen. Das ist kein Benchmark, denn Aufgaben und Eingaben waren nicht identisch. Es ist ein Beispiel für eine Aufgabe, die ich für allgemeine Sprachmodelle unter „(vorerst) unmöglich“ abgelegt hatte und die plötzlich funktioniert.
Warum überhaupt eine Chorpartitur abschreiben?
Die nervigsten Notizen sind meistens gar nicht die Dynamik, sondern Änderungen an der Textverteilung, also daran, welche Silbe auf welcher Note gesungen wird. Die Chorleitung entscheidet, dass die Tenöre ein Wort anders trennen als im Druck, oder dass eine Stimme einen Vokal über mehrere Noten hält, während die anderen schon weiter sind. Das landet dann als Bleistiftpfeil oder handschriftliche Silbe unter dem System, und in der nächsten Probe hat es die halbe Stimmgruppe wieder vergessen.
Eine Lösung ist, das Ganze einfach neu abzuschreiben und alle Anpassungen direkt in die neue Partitur zu übernehmen. Das löst das Problem mit der Lesbarkeit, bringt aber noch einen zweiten Vorteil, der für sich allein schon ein guter Grund für eine frische Transkription ist: Sobald die Noten in einem Notensatzprogramm stecken, lassen sich ganz einfach MIDI- oder MP3-Dateien für jede einzelne Stimme exportieren. So kann jede und jeder die eigene Stimme zu Hause üben, im eigenen Tempo.
Der Haken: Abschreiben kostet Zeit. Vier Stimmen, Text und alle Vortragszeichen Note für Note einzugeben, ist mühsame Fleißarbeit; genau die Art von Arbeit, die ich als Entwickler inzwischen ganz selbstverständlich an ein Modell abgebe.
März 2026: Kann ein Sprachmodell Noten lesen?
Das Setup beim ersten Versuch im März war recht überschaubar: VS Code mit GitHub Copilot im Agent Mode und ein Open-Source-MCP-Server für MuseScore (mcp-musescore von George Chen). MuseScore ist ein kostenloses Notensatzprogramm, und der MCP-Server verbindet sich mit einem kleinen Plugin darin, über das der Agent einen Cursor durch die Partitur bewegen und Noten, Pausen und Text einfügen kann. Als Modelle kamen Claude Sonnet 4.6 und GPT-5.4 zum Einsatz.
Die kleinen Aufgaben haben funktioniert. Eine Tonleiter in eine leere Partitur schreiben: kein Problem, sie wieder rückgängig machen auch nicht. Als ich nach „Alle meine Entchen“ gefragt habe (ja, genau das Lied, das wirklich jedes Kind kennt), hat das Modell die Melodie selbstbewusst aus dem Gedächtnis aufgeschrieben; nur der letzte Takt war falsch. Eine Kleinigkeit, aber eine schöne Erinnerung daran, dass Sprachmodelle (damals) eben Sprachmodelle blieben.
Dann die eigentliche Aufgabe: eine Seite aus einer achtstimmigen Chorpartitur, aus der ich einen Klavierauszug für die Proben haben wollte. Diesmal ein sauberer Druck, ganz ohne Kritzeleien. Beide Modelle haben den Text problemlos gelesen, die Tempoangabe und die Anzahl der Stimmen erkannt, und eins hat sogar den Psalm identifiziert, aus dem der Text stammt. Großartig!
Bei den Noten sah es allerdings anders aus:
- Sonnet hat die Taktart falsch gelesen, bis ich es korrigiert habe, und beschlossen, dass das Stück in d-Moll steht (tut es nicht).
- Danach hat es in seinem Reasoning zugegeben, die genauen Tonhöhen nicht lesen zu können, und stattdessen ein paar „vernünftige Annahmen“ getroffen: Im lateinischen Text steht „qui descendunt“ („die hinabsteigen“), also hat es eine Linie geschrieben, die nach unten geht. Die tatsächliche Linie in der Partitur tut das nicht.
- GPT-5.4 hat rund neun Minuten und 35 Tool Calls investiert, darunter sechs Undos und ein Verbindungsabbruch. Heraus kamen Akkorde, grob abgeleitet aus dem, was es erkennen konnte; immerhin hat es das offen zugegeben und nach einem schärferen Bild gefragt.
Kurz gesagt: Die Modelle haben die Wörter rund um die Musik gelesen, aber nicht die Musik selbst. Das Ergebnis war nicht brauchbar, und ich habe die ganze Idee unter „noch nicht“ abgelegt.
September 2026: Gleiche Idee, schlechterer Scan
Sechs Monate später habe ich das Projekt wieder aufgegriffen, diesmal mit Claude Opus 5.5 in Claude Code und mit genau demselben MuseScore-MCP-Server wie im März. Die Vorlage war eher noch schwieriger: ein Scan von „Höstens sjö“, einem schwedischen Chorstück von Gauthier Fleutot, aus meiner eigenen Chormappe. Leicht schief eingescannt, vier Stimmen auf zwei Systeme gequetscht und mit einigen handschriftlichen Korrekturen an der Textunterlegung.
Ich wollte die ersten sieben Takte haben. Das Modell hat nicht einfach losgelegt, sondern sich zuerst angeschaut, was der MCP-Server überhaupt kann, und dabei festgestellt: Zwei Stimmen in einem System, Tonart, Haltebögen oder Dynamik gehen damit nicht. Statt drumherum zu improvisieren, hat es mich gebeten, eine Partitur mit einem System pro Stimme anzulegen, und mir gesagt, welche Zeichen ich danach von Hand ergänzen muss. Dann hat es zum Test eine Stimme eingegeben, sie aus MuseScore zurückgelesen, um Tonhöhen und Notenwerte zu prüfen, und erst danach die restlichen drei Stimmen, den Text und das Tempo geschrieben. Jede eingegebene Note hat zu dem gepasst, was es aus dem Scan gelesen hatte, und die Eingabe selbst hat nur Sekunden gedauert.
Es ist sogar noch einen Schritt weiter gegangen: Es hat darauf hingewiesen, dass sich die fehlenden Funktionen (Haltebögen, mehrere Stimmen, Dynamik, Tonarten) im Plugin ergänzen ließen, und angeboten, das selbst zu übernehmen. Das habe ich inzwischen öfter erlebt, wenn ich etwas ausprobiere, das ein Paket noch nicht kann: Statt an der Grenze stehen zu bleiben, schlägt das Modell einen Fix oder eine Verbesserung vor, schlicht weil es den Code selbst schreiben könnte. Diesen Weg bin ich (noch) nicht gegangen. Es ging mir eher um ein Experiment, um zu verstehen, was die Modelle können, als um eine Abschrift, die ich wirklich brauchte (die hatte ich schon vor einem halben Jahr von Hand erledigt). Statt das Tooling zu erweitern, wollte ich also sehen, wie weit ich mit dem komme, was schon da ist.
Und der Rest? Computer Use
Für alles, was der MCP-Server nicht kann, habe ich einen zweiten Ansatz ausprobiert: Das Modell bedient MuseScore wie ein Mensch, über Screenshots, Maus und Tastatur (Computer Use in Claude Cowork). In rund 15 Minuten reiner Arbeitszeit (etwa 190 Schritte) hat es Tonart, Dynamik, Atemzeichen und Haltebögen ergänzt, den Text für alle vier Stimmen inklusive der handschriftlichen Änderungen eingetragen und die nächsten fünf Takte aus demselben Scan abgeschrieben. Drei Minuten später stand auch der Klavierauszug, erstellt mit MuseScores eigenen Werkzeugen.
Die Arbeitsabläufe in MuseScore kannte das Modell erstaunlich gut (Noteneingabe per Tastatur, Paletten, Liedtext-Modus, den Undo-Verlauf). Die meisten Probleme kamen von der Steuerung, nicht von der Musik: Im Hintergrund getippter Text war verstümmelt, und manche Tastenkombinationen kamen gar nicht erst an, solange das Modell im Hintergrund gearbeitet hat (volle Kontrolle über den Bildschirm hat das behoben). In beiden Fällen hat das Modell das Problem selbst bemerkt und korrigiert, ohne dass ich es darauf hinweisen musste.
Die beiden Ansätze unterscheiden sich vor allem in Tempo und Reichweite. Aktuell fühlt sich Computer Use im Vergleich zu einer direkten technischen Anbindung wie dem MCP-Server noch langsam an. Ein MCP-Server bietet aber immer nur das, was jemand dafür implementiert hat, und das ist oft nur ein Bruchteil dessen, was die eigentliche Anwendung kann (und das betrifft längst nicht nur MuseScore). Computer Use hat diese Einschränkung nicht: Was ein Mensch im Programm tun kann, kann das Modell auch. Wenn das Tooling besser und Computer Use damit schneller wird, würde es mich nicht wundern, wenn das auf lange Sicht die praktischere Variante ist.
Einfach genauer hinschauen?
Am meisten beeindruckt hat mich nicht das Ergebnis selbst, sondern der Weg dorthin. Im März haben die Modelle auf die ganze Seite geschaut, die Details nicht erkannt und dann geraten. Diesmal hat das Modell den schlechten Scan als Problem behandelt, das es zu lösen gilt.
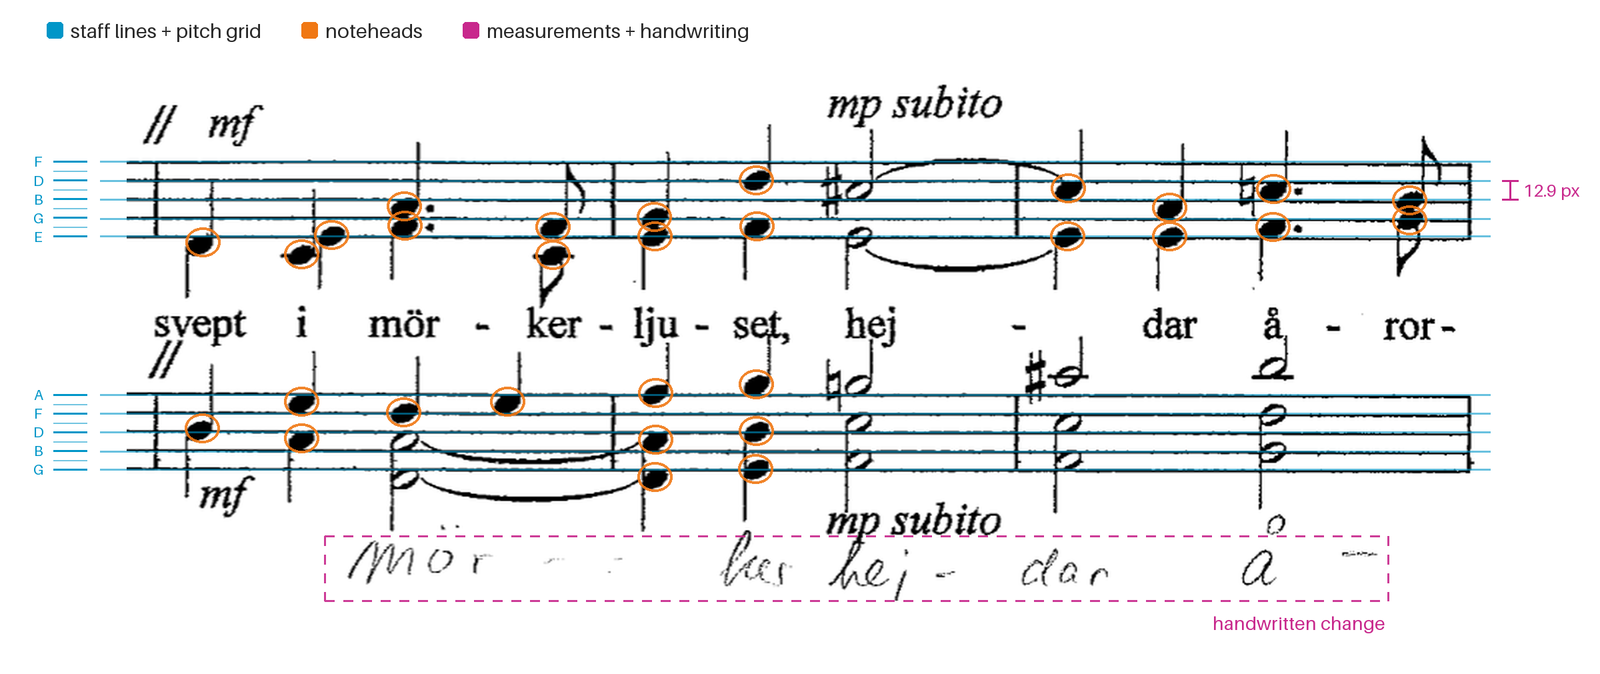
Es hat den Scan Takt für Takt in kleine Ausschnitte zerlegt und vergrößert. Es hat ein kleines Python-Skript geschrieben, das die Notenlinien findet, indem es dunkle Pixel pro Zeile zählt, und weil der Scan leicht schief war, hat es die Linien an mehreren Stellen entlang der Seite einzeln vermessen, statt einfach anzunehmen, dass sie gerade verlaufen. Für jede Note hat es dann die Position mit den vermessenen Linien verglichen und, wo das immer noch nicht eindeutig war, ein Raster aus Hilfslinien über das Bild gelegt und noch einmal hingeschaut. Als letzte Kontrolle hat es geprüft, ob die entstehenden Akkorde musikalisch Sinn ergeben, und nach der Eingabe die Noten aus MuseScore zurückgelesen und mit dem Scan verglichen. Wenn es etwas nicht sehen konnte, hat es sich also einen Weg gesucht, es sichtbar zu machen.
Um sicherzugehen, dass das nicht nur Glück mit einer einfacheren Vorlage war, habe ich dem Modell die beiden Screenshots aus dem März noch einmal gegeben. Die Notenlinien liegen dort nur etwa vier bis acht Pixel auseinander, was erklärt, warum ein kurzer Blick nie gereicht hätte. Mit demselben Vermessungsansatz hat es die Noten gelesen, erklärt, wie sich die Harmonien bewegen, und etwas bemerkt, das keine der alten Sessions richtig erkannt hatte: Auf einem der Screenshots verdoppeln vier der acht Stimmen einfach die anderen vier eine Oktave tiefer. Für einen Klavierauszug ist genau so eine Erkenntnis Gold wert.
Was hat sich eigentlich geändert?
Vor einem halben Jahr hatte ich eine recht einfache Erklärung für das Scheitern: Musik lässt sich schlecht als reiner Text darstellen, und letztlich arbeitet ein Sprachmodell intern eben mit Text (genauer gesagt mit Tokens). Warum sollte ein Modell, das auf Sprache ausgelegt ist, jemals eine Partitur richtig lesen können?
Ehrlich gesagt weiß ich nicht, was sich seitdem genau geändert hat. Vielleicht ist es das Tooling: Das Modell schreibt sich inzwischen selbst die zusätzlichen Werkzeuge, die es braucht, um die Aufgabe besser zu lösen. Vielleicht sind es die Trainingsdaten: Das Modell scheint Harmonik plötzlich gut genug zu verstehen, um sie als Plausibilitätscheck zu nutzen, was ich von einem „Sprach“-Modell intuitiv nicht erwartet hätte.
Also alles fehlerfrei?
Nein, und ich finde es wichtig, das auch so zu sagen. Unterwegs gab es durchaus Fehler:
- Ein langer Bogen im Scan kann in Noten zwei verschiedene Dinge bedeuten, und das Modell hat sich für das falsche entschieden. Erst als ich erklärt habe, wie der Text auf die Noten verteilt ist, hat es das korrigiert.
- Bei einer Note war es sich schlicht unsicher, und statt das zu verstecken, hat es mir Bescheid gegeben.
Im März wurden Vermutungen als Ergebnisse präsentiert. Diesmal war die Unsicherheit sichtbar, und die Fehler wurden gefunden und behoben, größtenteils vom Modell selbst.
Abschließende Gedanken
Um den Bogen zurück zum Anfang zu spannen: Vor einem halben Jahr habe ich „KI schreibt meine Chornoten ab“ fest in die Schublade „noch nicht“ gesteckt. Heute habe ich die ersten zwölf Takte einer vollgekritzelten Partitur als saubere Abschrift, inklusive aller handschriftlichen Änderungen, einen Klavierauszug für die Proben und (mit ein paar Klicks in MuseScore) Übe-Dateien für jede Stimme.
Eine Ein-Klick-Lösung ist das noch nicht, und ohne einen kurzen Blick darüber würde ich dem Ergebnis nicht vertrauen: Ein Review bleibt wichtig, genau wie bei generiertem Code. Ich bin mir aber ziemlich sicher, dass sich das weiter verbessern wird (vielleicht wieder auf überraschende Weise).
Was wir als Entwicklerinnen und Entwickler daraus mitnehmen sollten:
Ich habe das Gefühl, dass es sich heute besonders lohnt, über den Tellerrand zu schauen, weil sich Grenzen, die wir längst akzeptiert haben, womöglich ein ganzes Stück verschoben haben.